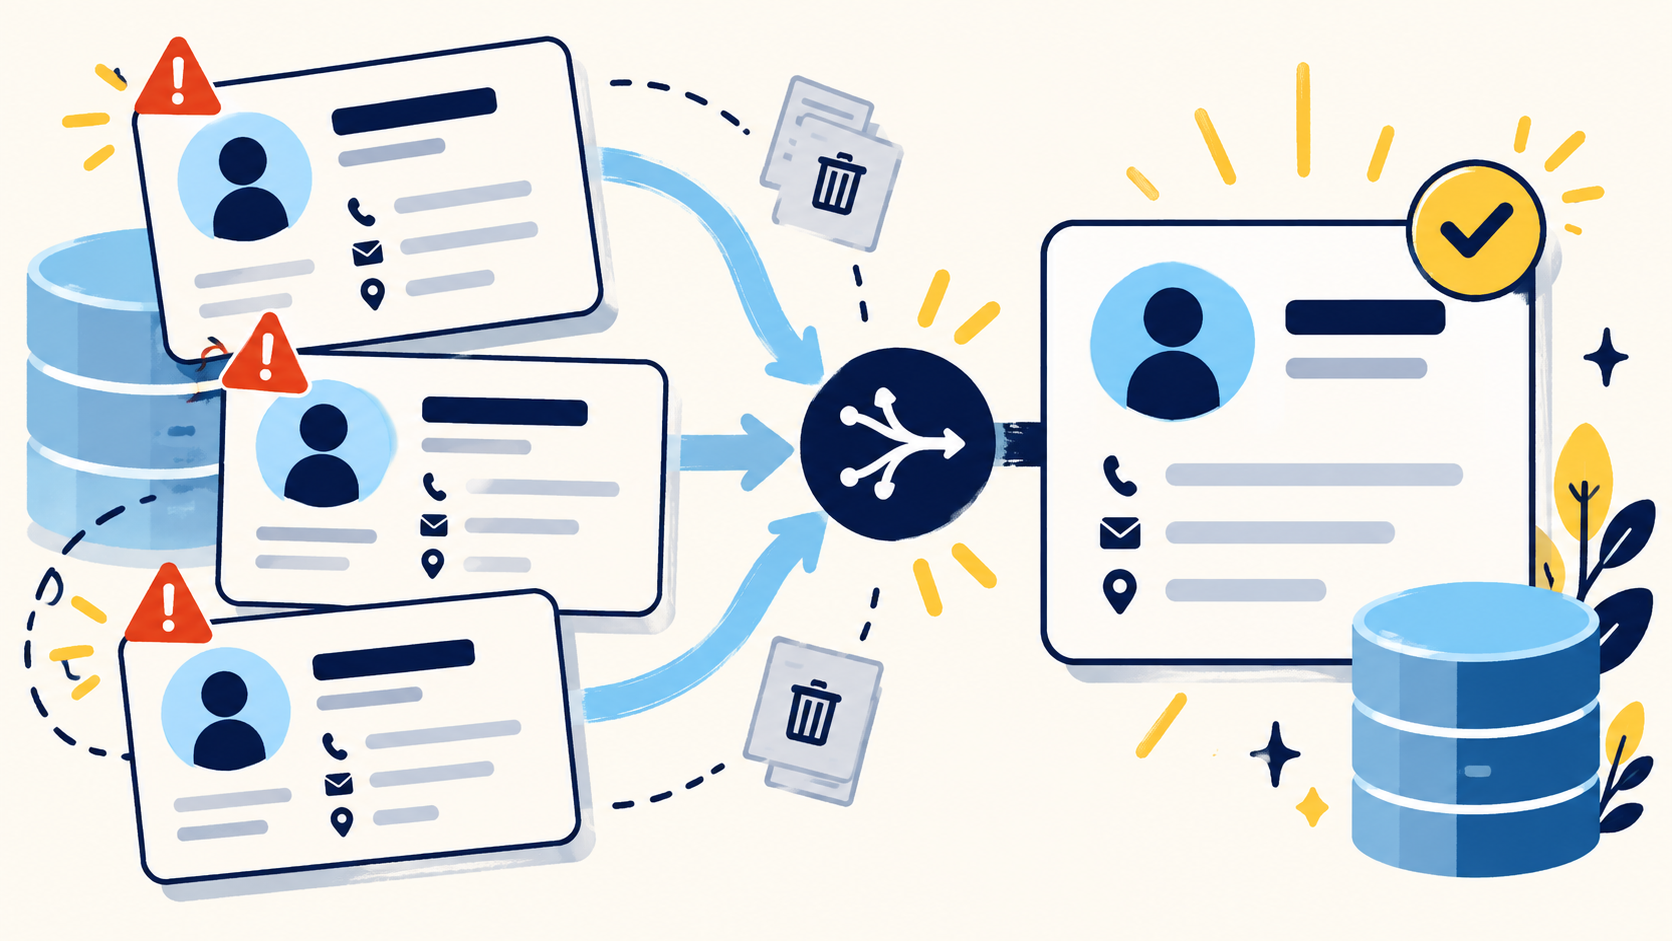
Normaliza los nombres de las empresas antes de compararlos
Los nombres de empresa sin procesar son claves de coincidencia poco fiables, ya que la puntuación, las mayúsculas, los sufijos, los espacios y las abreviaturas generan diferencias falsas. Un paso de normalización puede estandarizar el uso de mayúsculas y minúsculas, eliminar los espacios sobrantes, suprimir la puntuación cuando sea necesario y separar los sufijos legales habituales, como LLC, Inc., Ltd. o Corp., del nombre principal utilizado para la coincidencia.
La normalización debe generar un valor de referencia, no sobrescribir el nombre original de la empresa. Mantén el valor de visualización original para que el registro final conserve el nombre más útil desde el punto de vista empresarial una vez completada la correspondencia.
- Mantener el nombre original
- Crear un campo de comparación normalizado independiente
- Unificar la puntuación y los espacios
- Utilizar los sufijos legales de forma coherente
- Documentar las reglas de abreviación en lugar de inventarlas sobre la marcha, fila por fila
No te limites al nombre de la empresa
Dos registros con nombres casi idénticos pueden corresponder a empresas diferentes, mientras que dos registros con nombres distintos pueden pertenecer a la misma empresa. Para una coincidencia más precisa, se utilizan campos adicionales como el dominio del sitio web, la ubicación de la sede central, la dirección, el teléfono, la empresa matriz o un identificador estable de la empresa.
El dominio de un sitio web suele ser uno de los mejores indicadores a nivel empresarial, ya que es más estable que un nombre de visualización, pero no es perfecto. Las filiales, las franquicias, las unidades de negocio y las empresas con varias marcas pueden utilizar legítimamente dominios diferentes.
Distinguir las coincidencias exactas de las coincidencias aproximadas
Las coincidencias exactas suelen poder gestionarse automáticamente cuando la clave de coincidencia es fiable. Algunos ejemplos son los dominios normalizados idénticos o los nombres de empresa normalizados idénticos que, además, comparten la misma ubicación. Las coincidencias aproximadas requieren un umbral de confianza y, a menudo, un segundo campo antes de que puedan fusionarse de forma segura.
La similitud entre cadenas de texto resulta útil para detectar diferencias ortográficas y abreviaturas, pero debe considerarse una indicación y no una prueba concluyente. Una puntuación de similitud, por sí sola, no permite comprender la estructura empresarial.
- Alta fiabilidad: mismo dominio y nombre de empresa compatible
- Confianza media: nombre similar y misma ubicación o dirección
- Baja fiabilidad: solo el nombre es similar
- Revisión manual: relación entre empresa matriz y filial, franquicia, adquisición o ambigüedad de marca
Define la entidad empresarial de la que vas a eliminar duplicados
Antes de fusionar registros, decide si el archivo debe representar entidades jurídicas, marcas comerciales, empresas matrices, ubicaciones físicas o cuentas de ventas. Un mismo conjunto de datos puede tener diferentes respuestas correctas en función de esa definición.
Por ejemplo, una cadena de restaurantes puede constituir una sola cuenta en un modelo de ventas corporativas y cientos de establecimientos distintos en un proyecto de mercado local. La deduplicación debería preservar la granularidad del conjunto de datos, en lugar de forzar que todos los registros relacionados se agrupen en una sola fila maestra.
Utiliza las reglas de supervivencia para conservar los mejores valores
Encontrar los registros duplicados es solo la mitad del trabajo. La fase de fusión requiere reglas de prevalencia a nivel de campo que determinen qué valor prevalece. El valor más reciente puede ser el más adecuado para el recuento de empleados, mientras que un nombre legal verificado en una página web o respaldado por una fuente fiable puede merecer prioridad frente a un valor más reciente pero menos fiable.
DataDabble suele tratar la procedencia, el estado de verificación, la calidad de la fuente, la actualidad y la exhaustividad como señales independientes. Esto hace que la fusión sea explicable y reduce el riesgo de sustituir un valor sólido por otro más débil simplemente porque este último llegó más tarde.
Mantén un registro de auditoría de los registros fusionados
En el caso de datos empresariales importantes, anota qué filas se agruparon, qué registro se conservó y por qué. Un sencillo registro de fusiones puede conservar los identificadores originales, los identificadores emparejados, el método de emparejamiento, el nivel de confianza y el registro conservado.
Esto resulta especialmente útil cuando el archivo se utiliza para alimentar un sistema de CRM, un sistema de enrutamiento, un modelo de generación de informes o un proceso de enriquecimiento periódico. Si más adelante se cuestiona una fusión, el equipo puede reconstruir lo que ocurrió sin tener que empezar de cero.
Revisa manualmente los casos extremos
Los duplicados más difíciles de identificar no suelen ser errores ortográficos. Se trata de adquisiciones, filiales, franquicias, cambios de marca, sociedades de cartera, direcciones compartidas y empresas que gestionan varios sitios web. En estos casos, resulta útil recurrir a la búsqueda pública en Internet y al criterio humano.
Un buen proceso de deduplicación automatiza las coincidencias evidentes y reserva la revisión manual para aquellos registros en los que la relación comercial realmente importa. Esto resulta más rápido y seguro que intentar automatizar todos los casos con un único umbral.
Common questions
¿Cuál es el mejor campo para deduplicar los registros de la empresa?
No existe un campo que sea el mejor en todos los casos. El dominio de la página web suele ser un elemento sólido, pero una correspondencia fiable suele combinar el nombre de la empresa con el dominio, la ubicación, la dirección, los identificadores u otros datos contextuales de la empresa.
¿Deberían eliminarse los sufijos legales como «LLC» o «Inc.»?
Se pueden eliminar de un campo de comparación normalizado, pero el nombre original de la empresa debe conservarse para su visualización y como referencia.
¿Puede la coincidencia aproximada deduplicar de forma segura una lista de empresas por sí sola?
No de forma fiable. La búsqueda aproximada resulta útil para generar candidatos, pero las coincidencias ambiguas deben contrastarse con otros campos de la empresa o revisarse manualmente.
¿Qué debería hacerse con las filas duplicadas tras una coincidencia?
Utiliza las reglas de supervivencia a nivel de campo para fusionar los valores más sólidos, conservar el contexto de origen cuando sea necesario y registrar la relación entre los registros originales y los que se conservan.
Final thoughts
La deduplicación de nombres de empresas parece sencilla hasta que la misma empresa aparece bajo abreviaturas, denominaciones legales, marcas comerciales, nombres antiguos, empresas matrices y variantes específicas de cada ubicación. El objetivo no es eliminar todo lo que parezca similar, sino decidir qué registros representan a la misma entidad empresarial, conservar los mejores valores y mantener intactas las distinciones significativas.
Need help improving your business data?
DataDabble can research, clean, enrich, and maintain the records your team depends on.