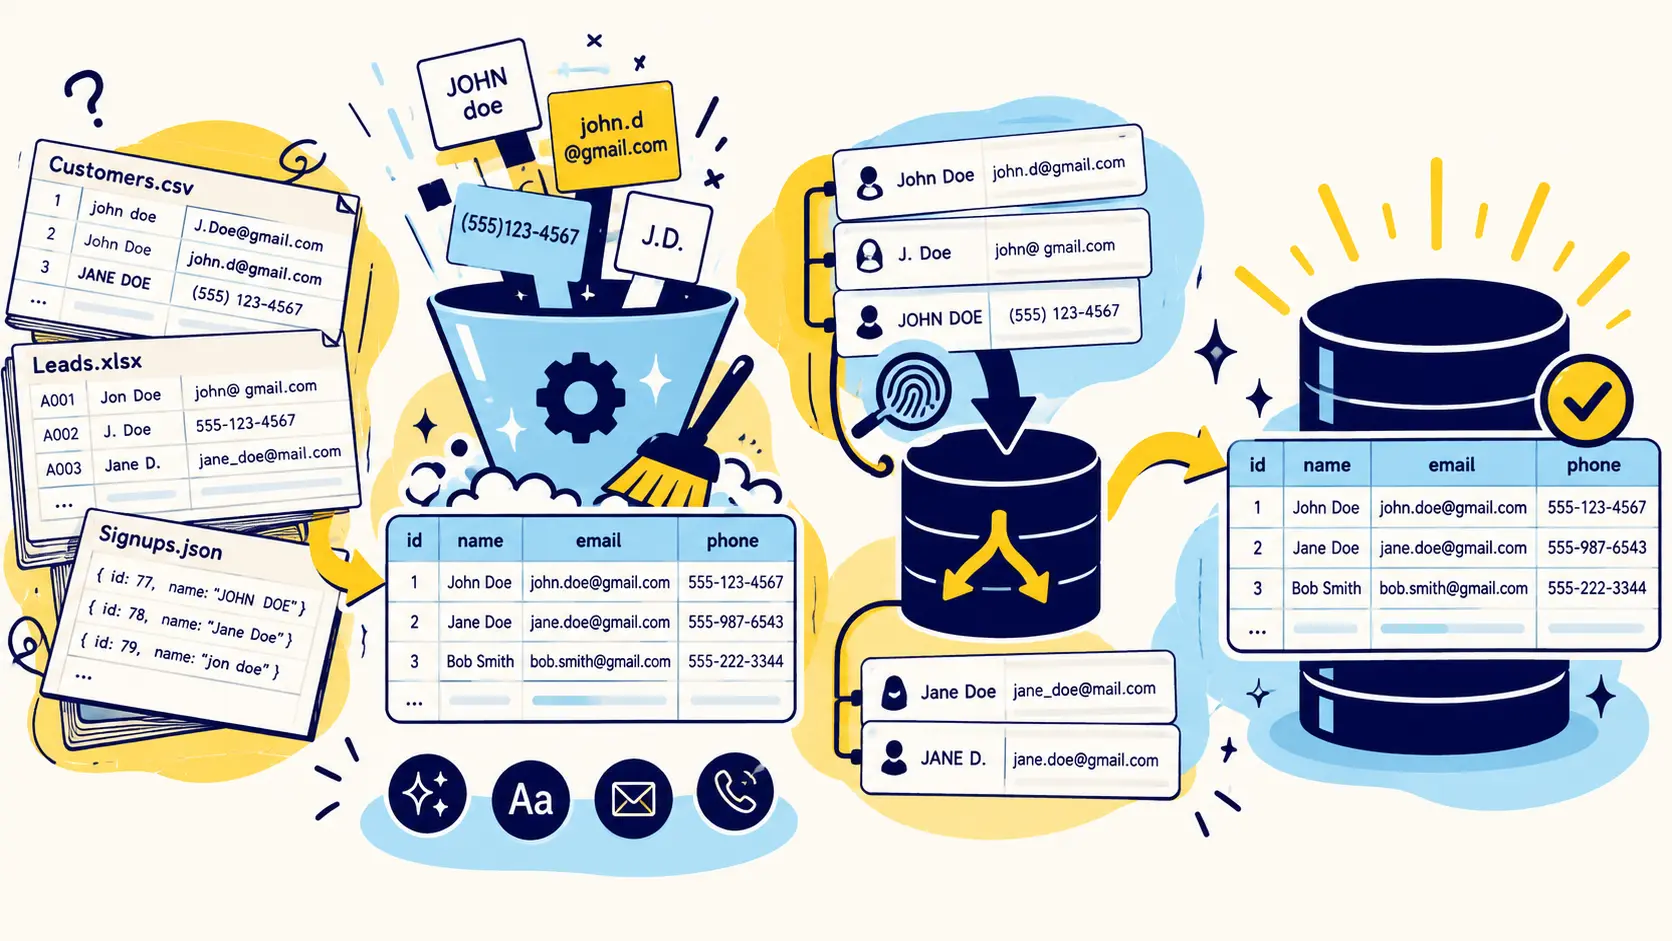
La limpieza corrige los valores; la deduplicación resuelve las entidades
La limpieza de datos permite estandarizar el uso de mayúsculas, las fechas, los formatos de los números de teléfono, los nombres de los países, los dominios, las direcciones, los títulos, las categorías y las convenciones relativas a los valores que faltan. También permite comprobar si los valores se ajustan a las reglas de negocio.
La deduplicación se lleva a cabo a nivel de registro. Comprueba si dos o más filas corresponden a la misma empresa, contacto, producto, ubicación, cuenta u otra entidad, y qué debe hacerse en caso afirmativo.
Limpia los campos correspondientes antes de eliminar los duplicados
La comparación de valores sin procesar genera falsos negativos innecesarios. «Acme Inc.», «ACME, Inc.» y «Acme Incorporated» pueden referirse todas a la misma empresa. La estandarización de los nombres de las empresas, los dominios, las direcciones de correo electrónico, los números de teléfono y las direcciones proporciona datos de entrada más claros a la lógica de comparación.
Esto no significa que todos los campos deban sobrescribirse en un único formato antes de la revisión. Conserva los valores sin procesar cuando sean útiles para la trazabilidad y crea campos normalizados específicamente para la comparación cuando sea pertinente.
Analiza el conjunto de datos antes de crear reglas
Antes de limpiar o fusionar cualquier dato, analiza el perfil del archivo. Evalúa los datos que faltan, los formatos de los valores, las tasas de duplicados, los sufijos comunes, los valores no válidos y los campos que están realmente lo suficientemente bien rellenados como para permitir la correspondencia.
El perfil determina qué es lo más realista. Un conjunto de datos con dominios web fiables permite realizar una correspondencia de empresas más precisa que un archivo que solo contenga nombres en texto libre. Un archivo de contactos con direcciones de correo electrónico profesionales coherentes puede utilizar reglas diferentes a las de uno compuesto principalmente por nombres y empresas.
Utiliza la coincidencia determinista y difusa para diferentes trabajos
Las reglas deterministas funcionan bien cuando existen claves sólidas, como una dirección de correo electrónico normalizada exacta, un dominio, un SKU o un identificador estable. La coincidencia aproximada es más adecuada para nombres, direcciones y otros campos que pueden variar de forma legítima.
Un proceso maduro suele combinar ambas cosas. Las reglas exactas gestionan los casos evidentes de forma eficiente, mientras que la lógica difusa identifica los pares candidatos que requieren pruebas que los respalden o una revisión manual.
- Estandarizar los campos clave
- Aplicar reglas de coincidencia exacta
- Generar candidatos con coincidencia aproximada
- Comprueba las pruebas secundarias
- Fusión con reglas de supervivencia
- Realizar el control de calidad final y conservar un registro de auditoría
No permitas que la deduplicación propague datos erróneos
Una fusión puede empeorar la calidad de los datos cuando el registro que se conserva contiene valores obsoletos, incompletos o no verificados. La validación a nivel de campo y las reglas de origen deben determinar qué datos se pueden conservar.
Por ejemplo, un registro de contacto duplicado con un cargo más reciente puede seguir conteniendo una asociación con una empresa anterior. Un registro de empresa con una dirección completa puede seguir haciendo referencia a una filial equivocada. La fusión requiere aplicar el criterio a nivel de campo, no solo a nivel de fila.
Diferenciar la eliminación de la consolidación
La deduplicación no siempre implica eliminar una fila. En algunos sistemas, es necesario que los registros relacionados permanezcan separados, ya que representan ubicaciones, unidades de negocio, suscripciones, productos o estados históricos diferentes.
Define primero el nivel de detalle deseado del conjunto de datos. Agrupa los duplicados reales, conserva las relaciones válidas y marca los registros dudosos para su revisión, en lugar de forzar la fusión de todas las similitudes.
Incorpora las reglas en las operaciones recurrentes
El mejor resultado no es conseguir un archivo perfectamente limpio en un solo día. Es un flujo de trabajo que garantiza que los nuevos datos se ajusten siempre a los mismos estándares. Aplica normas de normalización, validación, comprobación de duplicados y fusión a las futuras importaciones y tareas de enriquecimiento.
De este modo, la limpieza y la deduplicación dejan de ser un proyecto de emergencia para convertirse en una operación de datos repetible.
Common questions
¿Cuál es la diferencia entre la limpieza de datos y la deduplicación?
La limpieza mejora la calidad y la coherencia de los valores. La deduplicación determina si varios registros corresponden a la misma entidad y cómo deben consolidarse dichos registros.
¿Es necesario limpiar los datos antes de la deduplicación?
Normalmente sí, en el caso de los campos utilizados en la comparación. La estandarización reduce las diferencias erróneas y hace que la detección de duplicados sea más fiable.
¿La deduplicación implica siempre eliminar los registros duplicados?
No. Algunos registros deben fusionarse, otros deben conservarse como entidades relacionadas válidas y otros deben marcarse para su revisión, en función del nivel de detalle del conjunto de datos y de las reglas de negocio.
¿Cómo se consigue que un conjunto de datos siga sin duplicados a lo largo del tiempo?
Aplica las mismas reglas de normalización, validación, cotejo y fusión a las nuevas importaciones e integraciones y, a continuación, realiza controles de calidad periódicos.
Final thoughts
La limpieza y la deduplicación de datos están estrechamente relacionadas, pero resuelven problemas distintos. La limpieza mejora la calidad y la coherencia de los valores individuales. La deduplicación determina cuándo varios registros representan la misma entidad del mundo real. Cuando ambas tareas se realizan en el orden incorrecto, los duplicados son más difíciles de detectar y las fusiones pueden propagar valores erróneos. Cuando se diseñan conjuntamente, cada paso hace que el siguiente sea más fiable.
Need help improving your business data?
DataDabble can research, clean, enrich, and maintain the records your team depends on.